カメラからVRまで
映像を運ぶ実装
ステレオカメラの映像から人物領域を抽出し、VR内のアバターの見た目に反映する。撮影から描画までの実装記録。
 清水(ソフトウェア実装担当)
撮影
エンコード
PCへ伝送
人物マスキング
手指トラッキング合成
ステレオ描画
まえがき
相談された時点で決まっていたのは、体験のコンセプトだけだった。カメラの映像から人物の輪郭を切り出し、VR内のアバターに反映する。ソフトウェア側の実装は自分が担当した。実装の反復にはAIを使うvibe codingが効いたが、AIに任せきれなかったのは、実機と実データを見ないと判断がつかない部分、特にレイテンシに関わる設計判断だった。プロトタイプの見た目自体はすぐに作れても、それを破綻なく成立させるための下ごしらえには相応の時間がかかる。この記録は、その下ごしらえの中身を書き起こしたものである。
このパイプラインは、大きく分けて4つの実装からできている。ステレオカメラ本体とRaspberry Pi上でのH.264エンコード、PCへの独自UDP伝送、PC上でのRVM(Robust Video Matting)による人物マスキングと姿勢推定、そしてQuestの手指トラッキングとの合成を経てVRへステレオ描画するところまで。このどれか一つが欠けても体験は成立しない。
各区間でのレイテンシの問題と対策
自分の動きとアバターの動きにズレがあると、体験は「操作している感覚」ではなく「映像を見ている感覚」に変わる[1]。パイプラインは、カメラでの撮影からVRへの描画まで、性質の異なる4つの区間を通る。カメラからの伝送経路、ネットワークの伝送経路、PC側でのGPU推論の経路、そして描画までの経路。それぞれの区間で起きる遅延の原因は別物で、対策も別々に実装している。
| 区間 | 起きる問題 | 実装した対策 |
|---|---|---|
| カメラ→エンコード | 2台のカメラのフレームがずれる。エンコードそのものに時間がかかる。背景まで律儀に高画質で圧縮すると転送量が膨らむ。 | センサーのタイムスタンプで左右のフレームを突き合わせる。エンコーダはBフレームや先読みを切って速度優先の設定にし、人物領域の重要度マップをもとにマクロブロックごとに量子化の強さを変える仕組みも組んである(第2章)。 |
| エンコード→ネットワーク | UDPなのでパケットが届かない、順序が入れ替わることがある。 | 1フレーム分の欠損は1個までXORパリティで復元し、それ以上は復元せずに次のフレームへ進む(第3章)。 |
| ネットワーク→GPU推論 | 受信が遅れているフレームを律儀に処理すると、処理している間にもっと新しいフレームが届いてしまう。 | 受信側は常に一番新しいフレーム番号のものだけを組み立て、古いものは破棄する(第3章)。推論もGPU上に常駐させ、CPUとの往復を発生させない(第5章)。 |
| GPU→描画 | ステレオなので毎フレーム2枚のテクスチャを転送すると帯域とアップロード回数が倍になる。 | 左右を1枚のテクスチャにまとめて送り、描画時にシングルパス・インスタンシングで1回のアップロードから両目分を読む(第6章)。 |
| インタラクション全体 | PC側の推定結果(マスクや姿勢)が壊れる、または遅れて届くことがある。 | Questの手指トラッキングをゲームプレイ上の正としておき、マスクや姿勢の推定が失敗・遅延しても操作自体は止まらないようにする(第5章)。受信側から送信側へ10Hzでフィードバックを返し、送信ペーシングを調整する(第3章)。 |
- 自分の体ではないものを自分の体だと感じてしまう現象は、ラバーハンド錯覚(Rubber Hand Illusion)として知られ、視覚と運動感覚が高い精度で同期しているほど、その錯覚(身体所有感)が強く働くことが知られている。VRで他人の体に憑依する研究も、この延長線上にある。
ステレオカメラとRaspberry Pi上のエンコード
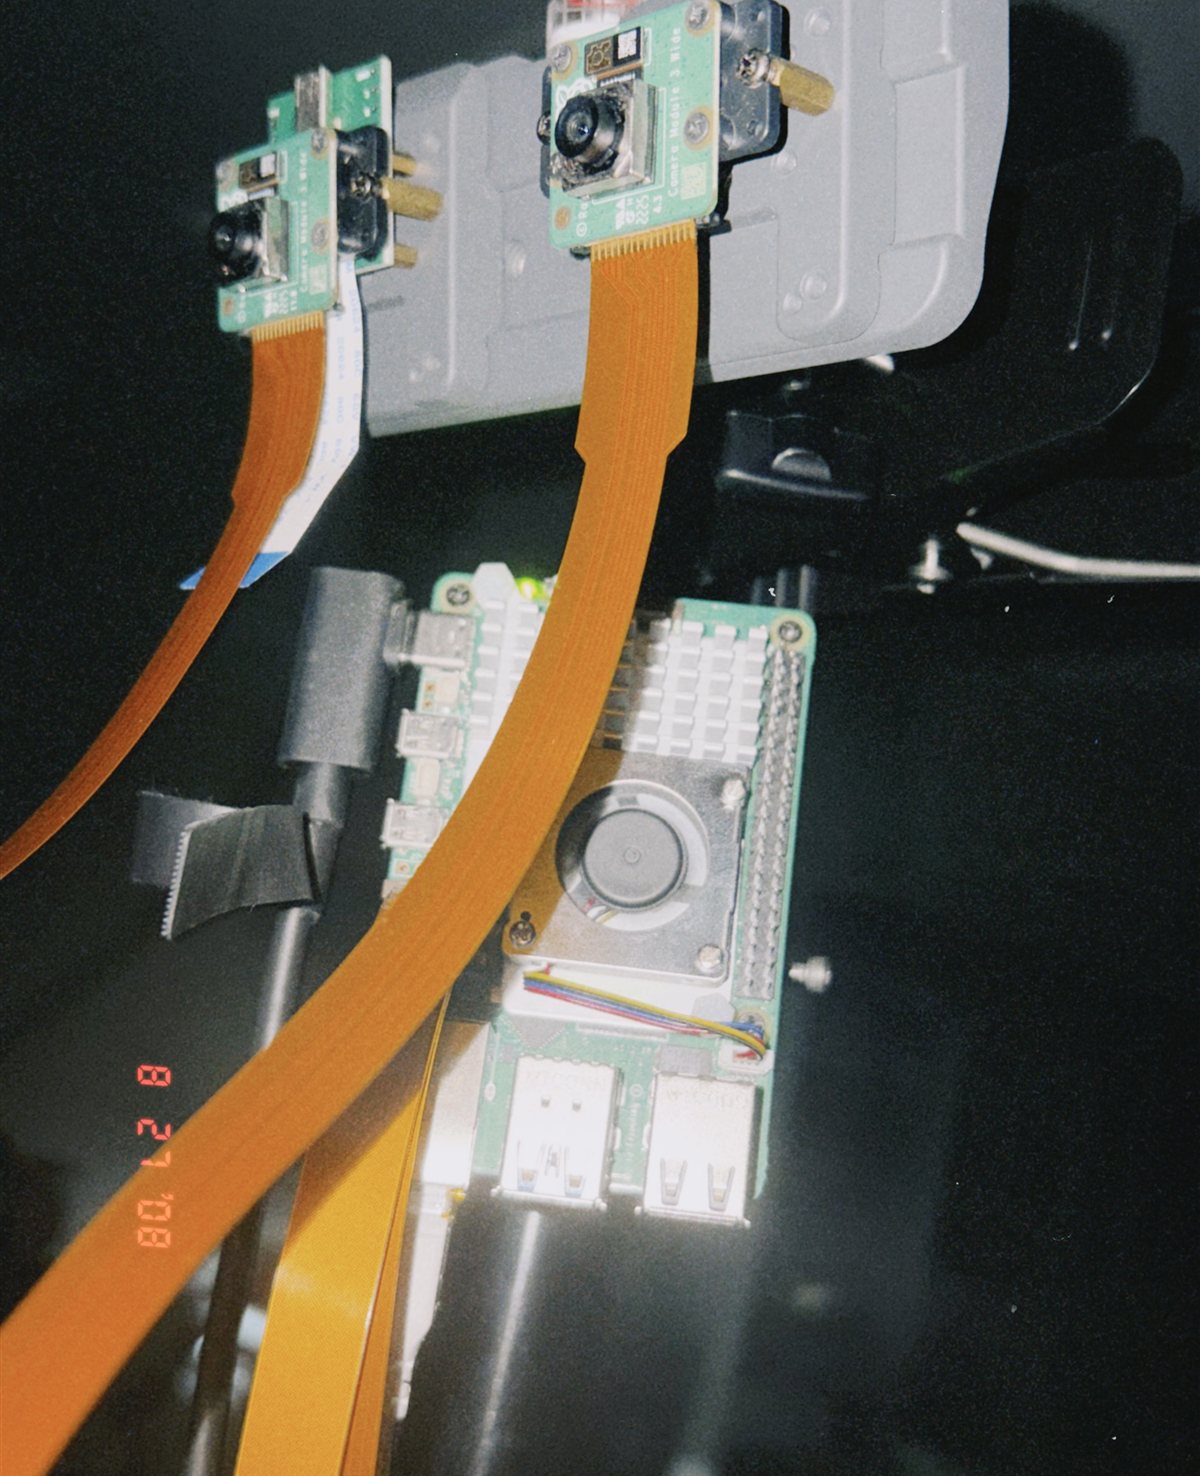
そもそもステレオカメラ自体、既製品を買ってきたわけではない。Raspberry Pi 5にRaspberry Pi用のカメラモジュールを2台取り付けて組み立てている。組み立てにあたっては、Raspberry Pi 5とカメラモジュールでステレオビジョンを構成した産業向けの事例(techietechnology.co.jp, 2025)を参考にした。専用のグローバルシャッターカメラや外部同期のハードウェアを使わなくても、Raspberry Pi 5であれば安価なカメラモジュール2台の映像を実用的な遅延で処理できる、という設計方針をそのまま踏襲している。
Raspberry Piには映像圧縮専用のハードウェアが載っているが、今回はあえて使わず、CPUで動くソフトウェアエンコーダのx264を使っている。理由は、圧縮の力配分を画面の場所ごとに自分で決めたいからである。この体験で画質が要るのは人物が写っている部分だけで、背景はいくら粗くても構わない。H.264の映像は画面を16×16画素の小さなブロックに分けて圧縮していて、x264はこのブロック1つ1つに「ここは丁寧に、ここは粗く」という指定を外から渡せる。一方、Raspberry Piのハードウェアエンコーダは映像全体の圧縮率の目標を選べるだけで、画面の中の場所ごとの指定は受け付けない。あわせて、圧縮効率と引き換えに遅延を増やす機能(時間的に後のフレームを参照するBフレームや、数フレーム先まで見てから圧縮を決める先読み)はすべて切り、とにかく速く送り出すことを優先する設定にしている。
左右の映像は、1枚の画像の左半分と右半分にそれぞれの目を並べるSide-by-Side(SBS)方式[1]でまとめている。SBSにした理由は主に描画側にある。後段のVR表示シェーダーが1枚のテクスチャのアップロードだけで両目分をまかなえるため、伝送量とテクスチャ転送回数を抑えられる(詳細は第6章)。
もう一つ、実装として組み込んでいるのが、Raspberry Pi上で動かす軽量なRVM推論による、圧縮の優先度づけである。PC側でVR描画用に使っているRVM(第4章・第5章で扱う本体のマスキングパイプライン)とは別に、Raspberry Pi上でもCPU向けに調整したRVMモデル(rvm_mobilenetv3_fp32.onnx)を動かし、その出力から32×32タイル単位の重要度マップを作る、人物のタイルは量子化を甘く、背景のタイルは強くする、という設計でH.264のマクロブロックごとの量子化オフセットに反映させるコードは書いてある。ただし正直に書いておくと、これが会場の本番機で最後まで安定して有効化されていたかどうか、原稿を書いている自分自身、完全な自信があるわけではない。Raspberry Pi 5にカメラ2台とエンコーダとニューラルネットワーク推論を同時に載せて30fpsを維持するのは、要求としてはかなり欲張りな部類で(Raspberry Pi本人の意見は聞いていない)、この部分が万一落ちても、その場合は単に「全タイル一律の優先度」にフォールバックするだけで、映像自体は途切れない設計にはしてある。
| 項目 | 値 |
|---|---|
| コーデック | H.264(libx264, software) |
| プリセット | ultrafast / zerolatency |
| プロファイル | constrained-baseline, Bフレームなし |
| フレームパッキング | Side-by-Side |
| 映像ストリーム | 1280×360 @ 30fps |
| マスクストリーム(別ポート) | 320×90, R8 |
| エンコード時間(片目あたり) | 7.4〜7.6 ms |
| Pi上のRVM推論時間 | 約18 ms/frame(30fpsの持ち時間の半分強) |
重要度マップはフレームごとに作り直すのではなく、指数移動平均(EMA)で更新している。人物が一瞬フレームの外に出ても、量子化オフセットの値が1フレームで急変しないようにするための処理である。
- 左右の映像を1枚にまとめる方式には、SBSのほかに、走査線を1本ずつ左目・右目と交互に並べるインターリーブ方式もある。今回はSBSを採用しているため、本文では詳しく扱わない。
独自のUDP伝送プロトコル
PCへの映像伝送にTCPを使わなかったのは、TCPが「ロスしたパケットを再送してでも順序通りに完全な形で届ける」ことを保証する仕組みだからである。この保証は、動いている自分の体をリアルタイムに映すという用途には合わない。少し前の完全な映像が届くより、今この瞬間の、多少欠けていてもいいから一番新しい映像が届くことの方が重要になる。そのため独自のUDPベースのフレーミングプロトコルを実装し、受信側は常に一番進んでいるフレーム番号のものだけを組み立てる設計にしている。
Ethernet上のパケットは、IPフラグメンテーションを避けるため1500バイトのMTUに収まるようチャンクに分割している。受信側はフレーム番号が後退しているパケットを破棄し、Raspberry Piの再起動などでフレーム番号が0に戻るような場合に備えて、連続して番号が後退したパケットが一定数(15回)続いたら基準をリセットするガードも入れている。
struct MetaPuppetPacketHeader {
  uint32  Magic;              // 'MPQ1'
  ushort  Version;            // = 1
  Flags   Flags;              // Keyframe / FecPresent / MaskPresent など
  uint32  StreamId;
  uint64  PacketSequence;
  uint64  FrameSequence;      // 受信側はこの値の前進だけを見る
  uint64  CaptureTimestampNs; // レイテンシ計測の起点
  uint32  ChunkIndex, ChunkCount;
  uint32  PayloadSize, FrameSize;
};
誤り訂正には、複数個の欠損を復元できるReed-Solomon系[1]ではなく、1フレームにつきXORパリティを1個だけ追加する単一パリティ検査符号[2](single parity check code)を使っている。理論上は2個以上のチャンクが欠けると復元できないが、パリティの計算がXOR一回で済み、実装も単純になる。1フレームの寿命がミリ秒単位のこの用途では、複数欠損に対応する複雑な誤り訂正の計算に時間をかけるより、次のフレームをそのまま受け取った方が結果的に速いと判断した。ガロア体の多項式演算には敬意しかないが、寿命ミリ秒のフレームに施す延命治療としては、いささか高級すぎる。誤り訂正の手厚さ(FECのグループサイズ)も、第2章の重要度マップを再利用してタイルごとに変えている。
受信側は、直近何秒かでどれだけパケットが届いていて、どれだけ欠けていたかを10Hzで数え、その結果を送信側に送り返している。送信側はこれを見て、回線が詰まっていそうなら送出のペースを落とし、余裕がありそうなら戻す、という調整をしている。もう一つ、キーフレーム(それ単体で映像を復元できる特別なフレーム。詳しくは後述)が全部届く前に、次の新しいフレームに追い越されてしまった場合には、受信側から送信側へ1回だけ再送要求のパケットを送る仕組みも入れている。
| 項目 | 値 |
|---|---|
| トランスポート | UDP(独自フレーミング) |
| 1パケットあたりのペイロード上限 | 1444 bytes |
| 誤り訂正 | 単一欠損XORパリティ |
| フレーム再構成方針 | 最新フレーム番号のみ採用 |
| 再同期ガード | 15回連続の逆行で基準をリセット |
| キーフレーム再送 | 1回だけ再送を要求 |
| フィードバック頻度 | 10 Hz |
- 誤り訂正符号の一種。元のデータに、多項式の計算で作った「余分なデータ」を追加しておくことで、一部が欠けても残りから元のデータを復元できるようにする方式。QRコードやCD・DVDの傷対策にも使われている。追加するデータの量を増やすほど、より多くの欠損に耐えられる。今回は「欠損は1個までしか復元しない」と割り切ることで、この多項式計算をXOR(対応するビットを比較し、異なっていれば1にする単純な演算)1回に簡略化している。
- 誤り訂正の最も単純な形(parity bit)。データを構成する複数のかたまりをXORで重ね合わせた「合計」のようなものを1個余分に送っておく方式。かたまりが1個だけ欠けた場合、残り全部と合計をもう一度XORすると、欠けた1個がそのまま復元できる。2個以上欠けると復元できない。
TensorRTに置き換えて高速化をする
MetaPuppetのPCVRパイプラインでは、ステレオカメラの映像から人物だけをリアルタイムに切り出すために、RVMをONNX[1]形式に変換したうえで、ONNX RuntimeのCUDA EP経由で動かしている。開発機を、巷で大変発火しやすいと噂のRTX 5070(Blackwell世代)のノートPCに切り替えるまでは、特に問題なく動いていた。Blackwellに切り替えたところ、いろいろな箇所でエラーが出るようになった。以下は、その経緯である。
RVMのrefiner部分にある、depthwise convolutionという種類の畳み込み層(4か所)が、cuDNN Frontend[2]の内部で失敗するようになった。エラーメッセージは短く、原因の手がかりはほとんど含まれていない。この手の一行エラーというのは、読んだ瞬間は情報が書いてあるように見えて、実際には「失敗しました」以上のことを何も教えてくれない、という性質を持っている。仕方がないので、乏しい状況証拠だけを頼りに推理を組み立てることになる。最初に立てた仮説は、「depthwiseはgroup convという特殊な形態だから、新しいGPU世代向けのカーネルがまだ用意されていないのだろう」というものだった。今にして思えば早計な仮説だった。
この仮説に基づき、対処法を考えた。GPUライブラリ側の修正を待つ、あるいはこの種類の層自体を使わないようモデルを設計し直す、という選択肢もあったが、それでは次のGPU世代でまた同じ問題に当たる可能性がある。そこで、失敗している4か所のdepthwise convolutionを、cuDNNの実行プラン選択を経由しない、もっと原始的な演算の組み合わせ(パディング→スライス→掛け算→足し算)に手作業で書き換えるという方法を選んだ。3x3のdepthwise convolutionは、パディング済みの入力から9通りのタップ位置ごとにスライスを切り出し、対応する重みを掛けて9個ぶん足し合わせる、という直接的な定義に従って書き下しただけの回りくどいやり方だが、数式は1項ずつ手で検算した。
書き換えた後も、元の演算とまったく同じ結果になっているかを確認する必要がある。2種類の精度で突き合わせた。1つは通常の32ビット浮動小数点(fp32)、もう1つは推論を高速化するために精度を落として使う16ビット浮動小数点(fp16)。結果は、fp32では出力のすべてが完全に一致し、fp16でも、人物のシルエットを表すアルファチャンネル(pha)と、直前までのフレームの情報を次のフレームに引き継ぐための内部状態(r1〜r4。RVMが動画のちらつきを抑えるために保持している、いわば記憶のようなもの)が完全に一致した。
これで解決したと、しばらくの間は考えていた。
問題の範囲を見誤っていた
パッチを当てて改めてテストすると、今度はdepthwiseでもなんでもない、通常の畳み込み層まで同じ症状で失敗した。エラーは「グラフの実行に失敗した」という趣旨の一行(CUDNN_FE failure 7: GRAPH_EXECUTION_FAILED)。cuDNN 9.xは個々の畳み込みを直接叩くのではなく、演算の組み合わせをグラフとして宣言してから、その実行プラン(どのカーネル・どのタイル分割・どのアルゴリズムで動かすか)をcuDNN Frontend自身に選ばせる設計になっている。今回の失敗は、この実行プラン選択のフェーズそのものが、この世代のGPU向けにまだ十分整備されていないことを示していた。
depthwiseが特別だったのではなく、cuDNN Frontendの実行プラン選択そのものが、もっと広い範囲で不安定だった。ノード単位で個別に迂回するやり方は、当たった箇所には確実に効くが、当たっていない箇所には何の効果もない。CUDA 12.8とcuDNN 9.8の組み合わせにアップグレードした結果、YOLOv3・YOLOv4・MobileNet V1が同じ症状で失敗するという報告も他所に見つかった。少なくとも環境固有の現象ではないことは分かった。
TensorRT-RTXへの乗り換えと、そこでの新しい失敗
方針を転換し、cuDNN経由のCUDA EPを避け、NVIDIAがクライアントRTX向けに提供しているTensorRT-RTX EPを使うことにした。GPU上に置いたテンソルの受け渡し先を、それまでCUDA専用の指定でハードコードしていたのを、どの実行プロバイダでも共通に使える指定へ書き直し、AUTO→TensorRT-RTX→CUDA→CPUという段階的なフォールバックも用意した。
TensorRT-RTXに切り替えると、cuDNN由来のConvの失敗は解消した。しかし今度は、RVM内部のResizeノード(バックボーンとrefinerの間で解像度を橋渡しするために、実行時入力であるdownsample_ratioに依存して動的にサイズを決めているもの)を、TensorRT-RTXのパーサーが解析できず、内部の形状チェックに矛盾がある、という趣旨の別のエラーで失敗するようになった。TensorRT系のパーサーは実行時に値が決まるResizeのサイズを扱いにくく、scales/sizes入力がグラフレベルの定数(initializer)でなければ解析できないという制約に、今回もそのまま引っかかった。
これには比較的すぐに糸口が見つかった。MetaPuppetは実際にはセッションごとに固定の解像度でしか推論しないため、downsample_ratioを実行時入力として渡す必要はそもそもなかった。モデル変換スクリプトを書き、この値をモデル内の定数として焼き込み、内部のResizeを完全な静的形状に置き換えた。
Resizeの問題は解消したが、今度はRVMの再帰状態r1〜r4をブロードキャストする部分で、「範囲外アクセス」という、モデル側の改造では対処できない、TensorRT-RTX側の内部の不具合に行き当たった。TensorRTのExpandは内部的にSliceレイヤーへ変換されることがあり、そこでの範囲外アクセスは、パーサーというよりビルダー側の不具合と見るのが妥当である。個別の失敗箇所をその都度モデル側で回避し続けるやり方には限界があることが見えてきた。
CPUフォールバックの確認と、最終的な実装
並行して調べていたGPU常駐CUDAパスは、例外すら発生させずに黙って失敗するという、輪をかけて診断のしづらい症状を見せていた。エラーを出して落ちるソフトウェアは誠実である、ということを、正常終了の顔をして何もしないソフトウェアに教えられることになるとは思わなかった。専用の診断APIを用意しても、Ort::Exception[3](ONNX Runtimeが内部で投げるエラーの型)以外の何かによって失敗しているらしく、原因はまだ特定できていない。ここで一度、CPU推論への安全なフォールバックが確実に機能するかをUnity上で確認した。結果は「推論に成功したフレームが14、失敗して飛ばしたフレームが0、最終ステータスは正常」を意味するログ(FramesInferred=14, FramesSkipped=0, LastStatus=OK)で、画面上の人物クロッピングも正しく表示された。
現在の実装は、TensorRT-RTXではなく、通常のTensorRT SDK[4](11.2.1系)のAPIを直接呼び出す経路を使っている。ONNXを完全な静的形状(batch=2、640×360または512×288の固定解像度、再帰状態r1〜r4のチャンネル数・空間サイズもすべて数値で固定)に特殊化し、onnx.checkerとshape inferenceを通し、CPU上で元モデルと特殊化モデルの出力(phaだけでなくr1〜r4も含めて)を突き合わせ、Unityを経由しないスタンドアロンの実行ファイルでエンジンのビルドを確認してから、GPUの描画バックエンド(Direct3D 11、詳しくは第5章)とCUDAとの相互運用コードに進む、という順序で検証している。
この過程でNVIDIAの開発者フォーラムを検索していたところ、Jetsonくんで同じRVMモデルをパースしようとして、まったく同じところでつまずいている同志の投稿を見つけた。世界のどこかに、同じ深夜に同じエラーメッセージと向き合っている人がいるというのは、地味に励みになる。その報告によれば、downsample_ratioの固定化だけでは不十分で、shapeに関わるテンソル[5]をINT64からINT32へ明示的にキャストしなければ、TensorRTのパーサーが"network input that is shape tensor must have type Int32"というエラーで落ちるとのことだった。この情報をもとに、モデル変換スクリプトにINT32化の処理を追加し、実装を完了している。
| 項目 | 値 |
|---|---|
| GPUバックエンド | TensorRT 11.2.1 直接呼び出し |
| モデル形状 | batch=2, 640×360 / 512×288 固定 |
| shape tensorの型 | INT64からINT32へキャスト |
| フォールバック順(ONNX Runtime経路) | AUTO → TensorRT-RTX → CUDA → CPU |
| 検証方法 | onnx.checker + shape inference 元モデルとの出力突合(pha, r1〜r4) |
TensorRTの直接呼び出しに載せ替えたあとの、展示シーンでの検証の様子。改良前との比較は第5章に載せている。
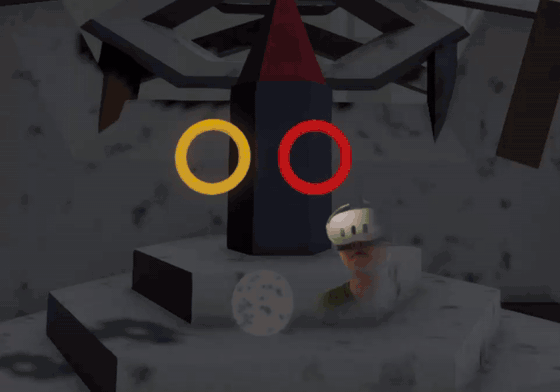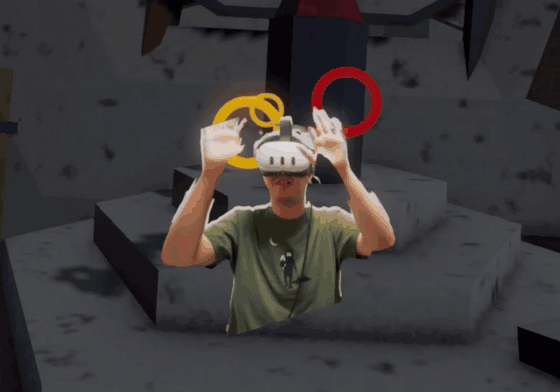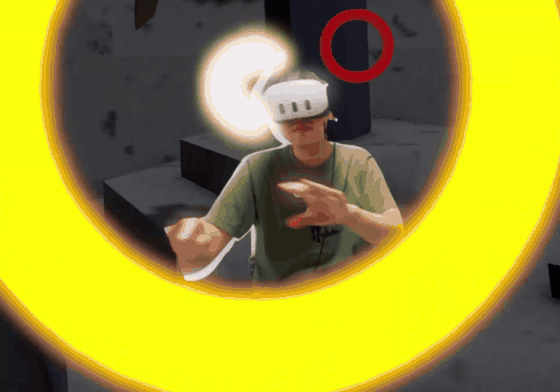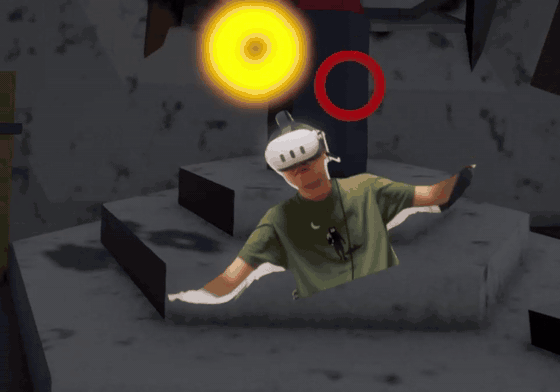
推論が動くようになったあとも、展示PCではシーン切り替えの直後にGPUごと落ちるTDRクラッシュが残っていた。その追跡と、D3D11とCUDAを同居させたままスパイクを消していった経緯は、長くなるので補遺「GPUを落とさないための実装」に分けて書いている。
- ONNXは、PyTorchやTensorFlowなど別々の学習フレームワークで作ったモデルを、共通の1つのファイル形式に変換して保存するための規格。ONNXに変換しておけば、学習に使ったフレームワークに縛られず、ONNX Runtimeのような別の推論エンジンで実行できる。
- cuDNN Frontendは、NVIDIAが提供するcuDNN(GPU向けのディープラーニング演算ライブラリ)のC++/Python API層。個々の演算を都度呼び出す旧来のAPIとは異なり、演算をグラフとして宣言し、実行時にそのグラフに合う最適なカーネル(実行プラン)をライブラリ側に選ばせる設計になっている(NVIDIA cuDNN Frontend documentation)。
- ONNX Runtimeが内部でエラーを検知したときに投げるC++の例外クラス。通常はこれを捕まえればエラーの内容を文字列として取得できるが、今回のCUDAパスの失敗はこの例外を経由せずに(クラッシュでもなく、正常終了の顔をして)静かに失敗していたため、原因の切り分けが難航した。
- TensorRTには、データセンター向けGPUも含めて幅広い環境を対象にした従来からのTensorRT SDKと、GeForce RTXなどクライアント向けGPUに絞って軽量に配布できるようにしたTensorRT-RTXという、系統の異なる2つの実装がある。TensorRT-RTXはアプリに同梱しやすい代わりに新しく、パーサーの対応範囲がまだ狭い。今回はTensorRT-RTX側のパーサーの不具合を避けるため、対応範囲の広い従来のTensorRT SDKを直接使う経路に落ち着いた。
- TensorRTでは、テンソルの中身が画素値のような「データ」ではなく、別のテンソルの形状(サイズ)そのものを表す場合があり、これをshape tensorと呼ぶ。ONNXの標準的な整数型はINT64だが、TensorRTのパーサーはshape tensorについてINT32しか受け付けないため、明示的なキャストが必要になる。
マスキング、姿勢推定、手指トラッキングの合成
体を切り出したあと、そのシルエットをVR内のアバターの動きに変換するには、関節や骨格の位置を推定する必要がある。ここではMediaPipeではなくRTMPoseを使っている。理由は、RTMPoseがRVMと同じD3D11[1]/CUDA相互運用の枠組みに乗り、CPUへ映像を戻すことなくGPU上に常駐したまま処理を回せるためである。RTMPoseは、RVMのマスクを常に受け取るわけではなく、目のID(左右)が一致していること、マスクが未来のフレームのものでないこと、許容ラグの範囲内であることを確認したうえで受け取る。この条件を満たさない場合はマスクを使わず、それでも体験自体が止まらないのは、Questのハンド・パームトラッキングが常にゲームプレイ上の正として扱われ、RVMやRTMPoseの結果とは独立して動いているためである。マスクと姿勢推定は、あくまで見た目の合成に使われるレイヤーであり、操作の判定そのものには使っていない。
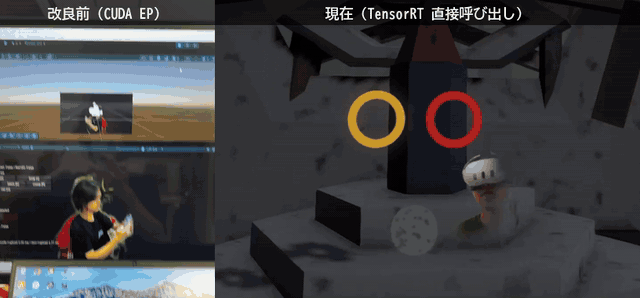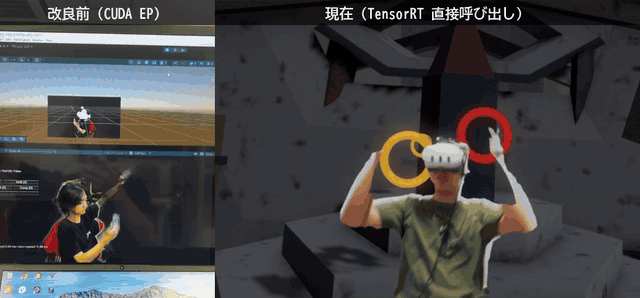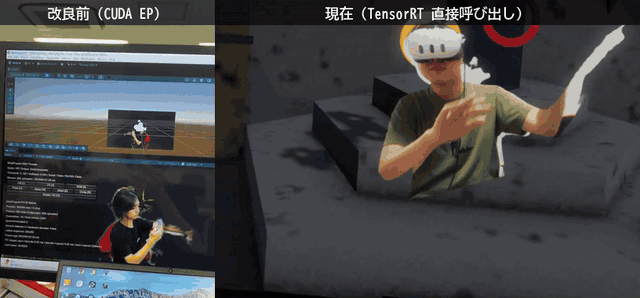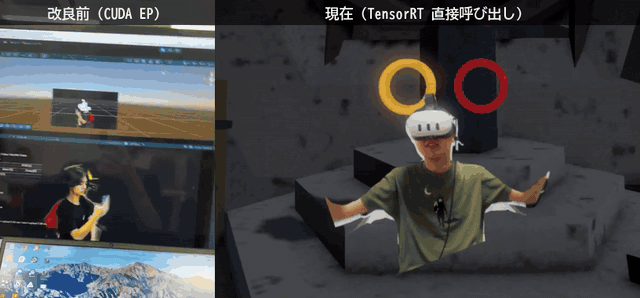
この章で述べる構成に落ち着く前、動かし始めたばかりのRVMはまだこの精度だった。マスクは大きな塊ごと欠け、手を振ると輪郭がまったく追従していない。
同じ改良前のRVMをUnityのシーンへ合成した映像と、この章の構成(TensorRT直接呼び出し、GPU常駐、境界のぼかしと時間方向のEMA)に落ち着いたあとの展示シーンを並べたのが次の比較である。腕を振っても輪郭が追従し、マスクが塊ごと欠けることはなくなった。
GPU常駐パイプラインで徹底しているのは、CPUとの往復を発生させないことである。カメラから来たNV12[2]の映像は、D3D11のコンピュートシェーダーでリサイズ・色空間変換(BT.709)・正規化・NCHW[3]並べ替えまでを済ませ、CUDA相互運用のバッファへそのまま渡り、ONNX RuntimeのIoBinding[4]へ永続的に結び付けられる。ステレオの左右2枚はbatch=2としてまとめて1回の推論に投げ、再帰状態(r1〜r4)は目ごとに独立したレーンで管理し、バッチ全体が成功したときだけ状態を入れ替える。推論結果のアルファチャンネルは、D3D11側に戻ってから境界のぼかしと時間方向のEMAを経て、そのままシェーダーに渡る。この経路では、ソース映像のホストからデバイスへの転送も、マスクのデバイスからホストへの転送も、バイト数はゼロになっている。
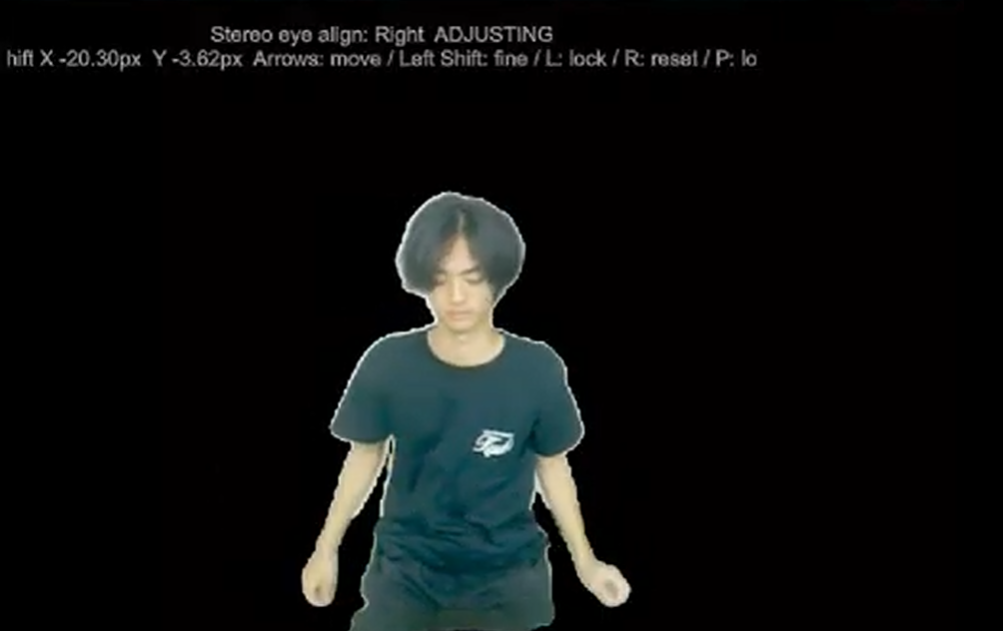
左右のカメラは物理的に完全には揃わないため、片方の目のマスクをもう片方に対して数ピクセル単位でずらして重ね合わせる調整が要る。これを手作業で追い込むためのデバッグ画面も作っていて、矢印キーでピクセル単位のずれを送りながら、RVMのマスク(人物の輪郭)を見ながら左右を合わせ込む。
同じ組み合わせ(リングバッファのスロットと再帰状態バンクのアドレスの組)に対してはCUDA Graph[5]のキャプチャを試み、成功すればその分の呼び出しオーバーヘッドを削れる。キャプチャが失敗する場合は通常のIoBinding経由の呼び出しに自動でフォールバックする。リングバッファも2スロットに留め、常に最新のフレームが処理対象になるようにしている。
- Direct3D 11。Windows上でGPUに描画命令を出すためのAPIの一つ。Unityの描画バックエンドとしても使われており、映像デコーダの出力やRVMの推論結果は、このDirect3D 11が管理するGPU上のメモリ(テクスチャ)としてやり取りされる。CUDAとの相互運用は、このDirect3D 11側のメモリをCUDA側からも直接読み書きできるようにする仕組みを指す。
- 映像の色を輝度(Y)と色差(UV)に分けて記録する形式の一つ。色差は輝度の半分の解像度に間引かれており、その分データ量が少なくて済むため、映像のデコード・エンコードで標準的に使われる(第6章で改めて触れる)。
- 画像を並べるバイト順の規約の一つ。N(枚数)→C(色チャンネル数)→H(縦)→W(横)の順に並べる、という意味で、ニューラルネットワークの推論エンジンが入力テンソルとして受け取る標準的な並び方である。これに対し、通常の画像ファイルやシェーダーはH×W×Cの順(HWC、1ピクセルごとにRGBが並ぶ)で扱うことが多く、推論に渡す前にこの並べ替えが必要になる。
- ONNX Runtimeの機能の一つ。通常は推論のたびに入出力データをCPUとGPUの間でコピーするが、IoBindingを使うとGPU上の特定のメモリアドレスを入出力として固定でき、コピーを省略できる。
- 推論1回につき、実際にはGPU上のカーネル呼び出しやメモリ操作が何十個も連なって実行されている。CUDA Graphは、この一連の呼び出しを「ノードとその依存関係」というグラフ構造として一度だけ記録(キャプチャ)しておき、以降はCPU側から1回の呼び出しでそのグラフをまるごと再生できる仕組みである。「グラフ」という名前は、この依存関係の構造そのものを指している。
SBSシェーダーで両目・色変換・合成をまとめて処理する
VRヘッドセットへ表示するシェーダー(MetaPuppetSbsUnlit.shader)にも、伝送量を減らすための工夫を入れている。第2章で触れたSBS(Side-by-Side)パッキングは、Unityのシングルパス・インスタンシング(1回の描画コールで両目分を処理する方式)と相性がよい。1枚のテクスチャをGPUに一度アップロードするだけで、左右それぞれの描画時にUV座標のUの半分だけをずらして読むことで両目分をまかなえるため、両目ぶん別々にテクスチャを転送・バインドする必要がなくなる。
float2 uv = float2(
    eyeUv.x * 0.5 + saturate(eye) * 0.5,
    eyeUv.y
);
// eye は unity_StereoEyeIndex(シングルパス・インスタンシング時)
// または _MetaPuppetEyeIndex(テスト時の明示指定)
このシェーダーはさらに2つの処理を同じフラグメントパスに詰め込んでいる。1つは、デコード済みのRGBAだけでなく、デコーダが直接出力するYUV NV12[1]平面(輝度R8プレーンと色差RG8プレーン)をそのまま受け取り、BT.601[2]の変換式でシェーダー内部でRGB化する経路。これにより、CPU側で色変換をかけるステップを省略できる。もう1つは、RVMの出力アルファを外部マスクテクスチャとして受け取り、クロマキー・マットキーとの切り替えも含めて背景合成をこのパスの中で完結させている点である。両目の描画、色空間変換、人物合成という3つの処理を1つのUnlitフラグメントシェーダーにまとめているのは、描画コール数とテクスチャアップロード回数を最小限に絞るためである。
あとがき
ここまで記録した対策は、単体で見ればどれも小さなチューニングにすぎない。カメラ側の重要度マップを圧縮とFECの優先度づけに使うこと、受信側が常に最新フレームだけを採用すること、GPU常駐パイプラインでCPUとの往復をゼロにすること、SBSパッキングで両目分のテクスチャ転送を1回にまとめること。これらは第1章の表に挙げた4つの区間それぞれに対する、個別の対策として実装している。1つ1つは地味で、単体で自慢できるような技術ではない。ただ、この地味な対策を4区間ぶん積み上げて、なおかつどこか1箇所でも手を抜くと体験全体が「操作している感覚」から「映像を見ている感覚」へ転落するというのが、この手の実装の面倒なところだと思う。
この記録が、同じようにGPU世代交代に殴られている誰かの深夜の検索に、たまたま引っかかれば幸いである。
補遺: GPUを落とさないための実装 — 展示PCで出たD3D11のTDRクラッシュを、プリウォームとD3D11/CUDAのロックの取り決めで消していった記録。