GPUを落とさない
ための実装
Unityの描画(Direct3D 11)とAI推論(CUDA / TensorRT)を同じGPUに同居させたら、シーン切り替えの数秒後にGPUごとリセットされるようになった。その原因を追い、落ちない構造に作り替えた記録。本編の第4章・第5章の続きだが、ここから読んでも分かるように用語には都度補足を付けている。
 清水(ソフトウェア実装担当)
正体を知る
取り違える
起こさない構造
取り合いを止める
残りを潰す
ガード
まえがき
| 何が起きたか | 体験の途中でGPUが2秒黙り込み、Windowsが「GPUが固まった」と判断してGPUをリセット。Unityはそれに耐えられず落ちた |
| 何が原因だったか | AIモデルをGPUに読み込む「初回だけ重い処理」が、映像を描いている真っ最中に走っていた。しかも読み込みを頼む2つの仕事が、同じGPUを順番待ちせずに触っていた |
| どう直したか | 重い処理は参加者がSTARTを押す前のイントロ画面で全部済ませておき、本番では「作る」のではなく「引き取る」だけにした。GPUを触るときは必ず同じ鍵を通すことにした |
| 用語 | ひとことで |
|---|---|
| D3D11(Direct3D 11) | WindowsでGPUに「これを描け」と命令するための窓口。Unityはこれで映像を描く。詳しくは脚注[1] |
| TDR | GPUが2秒応答しないときにWindowsがGPUをリセットする保護機能。アプリ側から見ると「デバイスが消えた」になる。脚注[2] |
| CUDA | NVIDIAのGPUで描画以外の計算(今回はAI推論)をするための仕組み。D3D11と同じGPUを別の窓口から使う |
| TensorRT / plan | NVIDIAのAI推論エンジン。学習済みモデルをそのGPU専用に最適化した「plan」というファイルにしてから読み込む。この読み込みが重い |
| デシリアライズ | planファイルをGPU上で使える形に展開すること。数百ミリ秒から秒単位でGPUを占有する |
| プリウォーム | 本番で使う前に、暇な時間に準備運動を済ませておくこと。この補遺の主役 |
| Present | 描き上がった映像を画面(ヘッドセット)へ送り出す命令。これが2秒止まるとTDRになる |
| RVM / RTMPose | RVM(Robust Video Matting)は映像から人物のシルエット(アルファ)を切り出すモデル、RTMPoseは体の関節位置を推定するモデル |
| ONNX Runtime / CUDA EP | ONNX形式のモデルを実行するライブラリと、その中でNVIDIA GPU向けに計算を行う実行プロバイダ(Execution Provider)。内部でcuBLAS・cuDNNを使う |
| cuBLAS / cuDNN | NVIDIAが提供するGPU用の行列演算ライブラリと、畳み込みなどニューラルネット向け演算のライブラリ。合わせて1GB超のDLL |
| WDDM | Windows Display Driver Model。Windowsがディスプレイドライバを管理する枠組みで、GPUメモリの割り当てや退避、TDRの判定はここで行われる |
| カーネル(CUDAカーネル) | GPU上で並列に走る小さなプログラム。推論エンジンはこれを何十個も連ねて1回の推論を行う |
| CUDA相互運用(interop) | D3D11が管理するGPUメモリをCUDA側からも読み書きできるように登録し、使う前後で所有権をmap / unmapで受け渡す仕組み |
| スレッド / 描画スレッド | プログラムの中で並行して動く実行の流れ。Unityは描画専用のスレッドを持ち、そこからD3D11に命令を積む。ネイティブプラグインの初期化や推論は別のスレッドで動く |
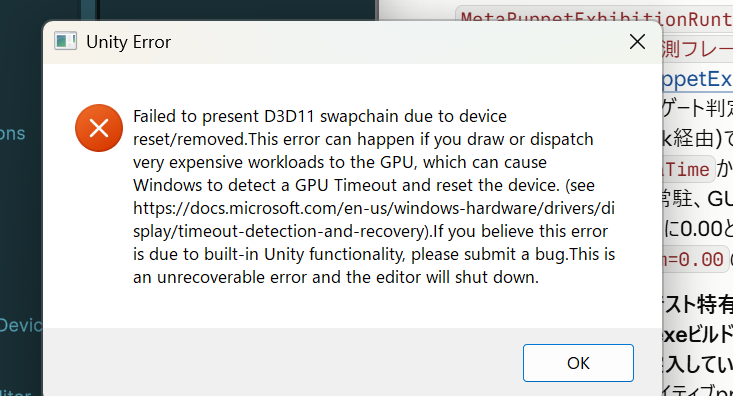
本編の第4章で、RVMの推論をONNX RuntimeのCUDA EPからTensorRTの直接呼び出しへ移した経緯を書いた。あれで推論そのものは動くようになった。ところが展示用のノートPCで通しの体験を回すと、今度は上の画面が出るようになった。Unityの描画バックエンドであるDirect3D 11[1]が「デバイスがリセットされた」と言って、アプリごと落ちる。推論のエラーではない。GPUそのものが一度死んで、Windowsが生き返らせた、という意味のメッセージである。
この現象はTDR[2](Timeout Detection and Recovery)と呼ばれる。WindowsはGPUに投げた仕事が既定で2秒応答しないと、ドライバごとGPUをリセットする。リセットされた側のアプリから見ると、それまで持っていたテクスチャもバッファも全部無効になり、Unityはこれを回復不能として終了する。「重い描画をすると起きる」とダイアログには書いてあるが、実際に重い描画をしていたわけではない。GPUが2秒黙り込む原因は別のところにあった。この補遺は、その原因を取り違えながら追い詰め、最終的に「スパイクを起こさない構造」に落ち着くまでの記録である。
- Direct3D 11(D3D11)。Windows上でGPUに描画命令を出すためのAPIの一つ。Unityの描画バックエンドとしても使われており、映像デコーダの出力やRVMの推論結果は、このDirect3D 11が管理するGPU上のメモリ(テクスチャ)としてやり取りされる。CUDAとの相互運用は、このDirect3D 11側のメモリをCUDA側からも直接読み書きできるようにする仕組みを指す。この補遺で「D3D11のタイムライン」と書いているのは、Unityの描画スレッドがこのAPIを通じてGPUに命令を積んでいく一本の列のことで、CUDA側の仕事もこの列に割り込む形で同じGPUを使う。
- Timeout Detection and Recovery。Windowsのディスプレイドライバ基盤(WDDM)が持つ仕組みで、GPUに送った処理が一定時間(既定2秒)完了しないと、GPUがハングしたとみなしてドライバをリセットする。画面が固まったままにならないための保護機構だが、アプリ側から見るとD3D11デバイスが突然「removed」状態になり、GPU上に置いていたリソースをすべて失う。
犯人を取り違える
症状には特徴があった。落ちるのはいつも、チュートリアルからメインシーンへ切り替わった直後、ログに「Native Init() returned status=0」、つまり姿勢推定RTMPoseの初期化が成功したと出た直後だった。展示ビルドではRVMはすでにTensorRTで動いている。この時点でONNX RuntimeのCUDA EPを読み込んでいるのはRTMPoseだけだった。CUDA EPは、行列演算ライブラリのcuBLASとニューラルネット演算ライブラリのcuDNNという、合わせて1GBを超えるDLL群を引き連れてくる。それをシーンの真ん中、つまりUnityの描画スレッドが同じGPUに毎フレーム命令を積んでいる最中に読み込む。GPUメモリ(VRAM)が足りなくなればWDDMは他のリソースをシステムメモリへ退避させ、その退避のあいだ描画のPresent(描き上がった映像をヘッドセットへ送り出す命令)は止まる。2秒を超えればTDRになる。筋は通っていた。
最初にやったのは、時間をずらすことだった。RTMPoseの初期化をシーンロードから最低6秒待たせ、ONNX Runtimeのグラフ最適化レベル(モデルを読み込むときに演算をまとめたり並べ替えたりする最適化の強さ。ALLが最大)もALLからBASICへ下げた。セッション(読み込んだモデルと実行環境をまとめたオブジェクト)を作るだけで、GPUの命令列を止めるほど重かったからである。あわせて、体験の開始をRTMPoseの準備完了から切り離した。一人称のゲームプレイはQuestのハンドトラッキングだけで成立するので、姿勢推定を待つ理由がなかった。これで落ちる回数は減ったが、消えてはいない。スパイクの位置が6秒後ろへ動いただけで、スパイク自体はそこにあった。
次にやったのは、犯人と目していたCUDA EPを消すことだった。RTMPoseもRVMと同じくTensorRTの直接呼び出し(ONNX Runtimeを介さず、TensorRTのSDKを自分のコードから直接使う経路)に載せ替え、ビルドからcuBLAS・cuDNN・onnxruntime_providers_cuda(CUDA EP本体のDLL)を一切同梱しないようにした。展示PC側の検証スクリプトも、これらのDLLがプラグインフォルダに残っていたら失敗するようにした。これで解決したと思って展示PCで3回回したところ、2回落ちた。
ここでようやく、DLLの読み込みが犯人ではなかったと分かった。残っていたのは、TensorRTのエンジンをplanファイルからGPUへ展開する「デシリアライズ」と、GPU上で走る小さなプログラム(カーネル)を初めて読み込むときのコストだった。どちらも「初回だけ重い仕込み」で、ONNX Runtimeを消しても残る。どちらもONNX Runtimeを消しても消えない。ついでに一つ、自分で仕込んだ悪化要因も見つけた。CUDA EPを使っていた頃の設定を引きずって、CUDAモジュール(カーネルをまとめたもの)の読み込み方式をEAGER(起動時に全部読む)にしていた。cuDNNの網羅的なアルゴリズム探索が初回推論に集中していた頃はそれが正しかったが、TensorRTではNVIDIA自身がLAZY[1]を推奨している。planには、実際の入力サイズでは一度も呼ばれないカーネルの変種まで入っている。それを全部、初期化の瞬間に読み込むのは、まさに軽くしたい瞬間を自分で重くしていたことになる。LAZYへ戻し、環境変数に上書きされないよう3か所のコードで明示的に設定した。
CUDA_MODULE_LOADING。CUDAが実行ファイルに埋め込まれたGPUカーネルをいつGPUへ読み込むかを決める設定で、EAGERは初期化時に全カーネルを、LAZYは初めて呼ばれたカーネルだけをその場で読み込む。CUDA 11.7以降の既定はLAZYだが、環境変数で上書きできるため、この実装では起動時にプログラム側から明示的にLAZYを設定している。TensorRTのベストプラクティスにも、初期化時間とピークメモリを減らすためにLAZYを使うよう書かれている。
スパイクを起こさない構造にする
重い処理を軽くする方向には限界がある。planのデシリアライズは、どうやっても数百ミリ秒から秒のオーダーでGPUを占有する。それなら、起きる時刻を選べばよい。参加者がイントロ画面でSTARTを押すまでの間、GPUはロゴを描いているだけでほとんど暇である。この時間に、あとで必要になるものを全部作っておき、ネイティブプラグイン(DLL)の中に保持しておく。シーンが始まって映像が来たら、作り直すのではなく保持してあるものを引き取る。これが現在の構造で、mppc_vision_prewarmという名前のワーカーがイントロ画面の裏で4段階を進める。画面の左下に「GPU vision warm-up n/4」と出ているのがそれである。
難しかったのは、RVMもRTMPoseも「どのD3D11デバイス(Unityが使っているGPUのハンドル)を使うか」を、Unityから最初の映像テクスチャが渡されて初めて知る設計だったことである。映像が届く前には、そもそも相手が分からない。そこでプリウォームは、D3D11デバイスが載っているアダプタからCUDA側のデバイス番号を逆引きして先に作っておき、あとで本番の初期化が来たときに「同じデバイス・同じplan・同じ入力サイズ」であることを確認してから引き渡す。条件が一つでも合わなければ引き渡さず、従来どおりその場で作る。安全側に倒した設計だが、この「合わなければ黙って作り直す」が後で罠になった(第4章)。
もう一つ、エンジンのプリウォームだけではTDRは止まらなかった。RTMPoseに渡す入力用のメモリ(D3D11側で作ったUAV付きバッファ[1])をCUDA側からも読めるように登録する処理(cudaGraphicsD3D11RegisterResource)が、まだ描画中のGPU上で走っていたからである。この登録は、D3D11とCUDAが初めて握手するときにだけ起きる重い手続きで、デシリアライズと同じ種類のスパイクを作る。前処理リソースの構築を関数に切り出し、プリウォームの第3段階で先に作って登録し、本番の初期化はそれを受け取るだけにした。
あわせて、体験のループ構造も変えた。以前は参加者が一人終わるたびにRVMとRTMPoseをシャットダウンし、次の参加者で初期化し直していた。これでは参加者のたびにスパイクの機会を作っていることになる。現在はワーカーとエンジンをプロセスの寿命いっぱい常駐させ、シーンの切り替えではpause/resumeするだけにしている。pauseはフレームの受け入れを止めるだけで、GPU上の資源(エンジン、バッファ、CUDA登録)には触らない。
この構成に切り替えてから、展示PCでの検証は3セッション、うち1セッションはRVMと姿勢推定を有効にしたまま5000フレーム以上を回して、例外(C#側のエラー)ゼロ、CUDA相互運用エラー(map / 登録の失敗)ゼロ、TDRゼロだった。
- Unordered Access View。D3D11でコンピュートシェーダーがバッファやテクスチャに任意の位置で読み書きするための「窓」。RTMPoseの前処理は、デコード済みのNV12映像をコンピュートシェーダーでリサイズ・色変換・正規化してこのバッファに書き込み、CUDA側がそのバッファをそのまま推論の入力として読む。
D3D11とCUDAの取り合いを止める
プリウォームを展示PCで試した夜に、もう一つ別種の問題が見つかった。症状は「たまにきれいなCUDA相互運用エラーで止まり、たまにエラーログを一行も残さずTDRで落ちる」。タイミングで結果が変わるというのは、典型的な競合の症状である。
原因は、RTMPoseの初期化がバックグラウンドスレッドで、Unityの描画スレッドと同じD3D11デバイスを排他制御なしに触っていたことだった。D3D11のデバイスコンテキスト(命令を積む窓口)は、本来スレッドセーフではない(複数のスレッドから同時に使うことを想定していない)。UnityはID3D11Multithread[1]を有効にしてこの窓口を排他制御しているが、そのロックは「取りに来た側」しか守らない。推論のたびに行う所有権の受け渡し(map / unmap。このメモリを今からCUDAが使う、使い終わって返す、という宣言)には、すでにこのロックをかけていた。ところが初期化時のデバイス問い合わせやリソース登録には、かけていなかった。描画スレッドがPresentしている最中に、別スレッドがロックを取らずに同じデバイスのリソースを登録しにいく。運がよければエラー、運が悪ければドライバがGPUごと止まる。初期化側も同じロックで囲み、ついでにエラーの中身をcudaGetErrorString(CUDAのエラーコードを説明文にする関数)とGetDeviceRemovedReason(D3D11デバイスが消えた理由を返す関数)から文字列として取り出し、Unity側に「ステータス -2011」という数字ではなく理由が読める形で返すようにした。
| 場面 | 取り決め |
|---|---|
| 初期化(デバイス問い合わせ、リソース登録) | 描画スレッドと同じID3D11MultithreadのEnter/Leaveで囲む。以前は無防備 |
| 推論のたびの所有権の受け渡し | map / unmapの瞬間だけロック。推論本体(数ミリ秒〜十数ミリ秒)はロックの外で走らせる。推論の間ずっと握ると、描画スレッドのPresentがその時間止まり、積み重なるとTDRの原因になる |
| マスクのテクスチャ書き戻し(描画スレッド側) | ロックが取れなければ待たずにそのフレームを飛ばし、前のマスクを使い続ける(第4章) |
| CUDAカーネルの読み込み | LAZYを明示設定。初期化の瞬間に全部読まない |
| planファイル | GPUとドライバの組み合わせごとの成果物として扱い、展示PC上で生成する。リポジトリには入れない |
| 同梱するランタイム | nvinfer(TensorRT本体)のみ。ONNX RuntimeのCUDA EP・cuBLAS・cuDNNのDLLがプラグインフォルダに残っていたら検証スクリプトが失敗する |
| 失敗の可視化 | ステータスコードに加えて、CUDA/D3D11の理由文字列をmppc_pose_get_last_errorで返す |
「ドライバとCUDAの不整合」と一言で呼んでいたものは、実際には二つに分けられる。一つは同じデバイスを複数スレッドが同時に触る問題で、これは上のロックの取り決めで止まる。もう一つは作った環境と使う環境のバージョンが違う問題で、TensorRTのplanファイルはビルドしたGPUの世代(アーキテクチャ)とドライバのバージョンに縛られている。別のPCで作ったplanを持ち込むと、動かないならまだしも、動いたふりをして遅かったり不安定だったりする。だからplanは展示PC上でprepare_rvm_tensorrt.ps1とprepare_rtmpose_tensorrt.ps1で作る手順にし、リポジトリには置かない。ビルド自体も、TensorRT版ではONNX RuntimeのCUDA EPとその依存DLLを同梱しないようCMakeで切り、古いDLLがプラグインフォルダに残っている状態を検証スクリプトが弾く。「消したはずのものが残っていて別の経路で読み込まれる」というのは、第1章で3回中2回落ちたときにも疑った類の混乱で、これを構造的に起きなくしておきたかった。
ID3D11Multithread。D3D11の即時コンテキストを複数スレッドから使うときに、呼び出しを直列化するためのインターフェース。Enter()とLeave()でクリティカルセクションに入る。Unityは自前の描画スレッドを守るためにこれを有効にしているが、ネイティブプラグイン側が同じデバイスを触るときは、プラグイン側も明示的にEnter/Leaveしない限り守られない。CUDAのcudaGraphicsMapResourcesはD3D11のコンテキストを内部で使うにもかかわらず、この保護を自動では通らない。
レビューで残りを潰す
ここまでの変更を本線に取り込んだあと、差分約6000行を改めてレビューにかけた。ここから先はコードの細部に入るので、第5章まで飛ばしてもらっても構わない。方針として、展示までは1〜4行で済む局所的な修正だけを入れ、状態機械の統合やファイル分割のような設計変更は展示後に回すことに決めた。動いている構成をいじる方が、残っているバグより危ないからである。見つかったものの中で、体験に直接響くものを挙げる。
| 問題 | 何が起きるか | 修正 |
|---|---|---|
| プリウォーム済みエンジンが一度も引き取られていなかった | プリウォーム側はUnityのPath.Combine(スラッシュ区切り)、本番側はPath.GetFullPath(バックスラッシュ)でplanのパスを作っており、文字列の完全一致で比較していたので必ず不一致になる。第2章の「合わなければ黙って作り直す」が毎回発動し、ライブのデシリアライズが残っていた | 比較をlexically_normal()で正規化した形に変更(2行) |
| マスク処理だけの失敗でプロセス全体がロックされる | RVMの初期化失敗が「最終シャットダウン」経路(アプリ終了時にだけ通るはずの、GPU資源を全部解放して二度と初期化しない経路)に流れ、以後ステレオ映像の開始も拒否される(戻り値 -6)。以前は「マスク無しで映像は続く」だった | マスクだけ止めて映像は続ける経路に戻し、-6のときは専用のログ行を出す |
| 姿勢推定が一度こけると二度と戻らない | シーン切り替えでシャットダウンではなくpauseを使うようになったため、失敗フラグを消す機会がなくなっていた | 同じ設定での再初期化で失敗フラグをクリア(1行) |
| 初期化中のpauseでプリウォーム済みエンジンを捨てる | キャリブレーションが速い参加者だと、姿勢推定のウォームアップ中にpauseが入り、引き取ったばかりのエンジンとCUDA登録を破棄して次回ライブで作り直す | キャンセル時はエンジンを保持し、次のresumeではウォームアップだけやり直す |
| 描画スレッドがマスク初期化の完了を待ってしまう | マスクをテクスチャへ書き戻す処理が初期化と同じロック(mutex)を取りにいき、ウォームアップの間ステレオ表示が止まる | 描画スレッド側はtry-lock(取れなければ待たずに諦める取り方)にし、取れなければそのフレームを飛ばして前のマスクを使う |
| resumeがデコーダを不要にリセットする | GPU直接パス(デコーダの出力をCPUを経由せずD3D11テクスチャへ渡す経路)がまだ有効になる前にpauseが入ると、健全なH.264デコーダを壊してキーフレームを要求し直す。手動でGPU直接パスを切った設定も勝手に戻す | ホスト(Unity)側の明示的な無効化を別フラグで持ち、resumeでは触らない。健全なresumeでもIDR(前のフレームに依存せず単独で復号できるフレーム)だけはカメラ側に要求する |
一番上の項目は、素直に言って恥ずかしい。第2章で「5000フレーム回してTDRゼロ」と書いたが、その検証のとき、RVM側のプリウォームは実は空振りしていたことになる。TDRが出なかったのは、第3章のロックとLAZY、それに姿勢推定側のプリウォーム(こちらは偶然両方が同じパスの作り方だった)が効いていたからで、RVM側はまだライブでデシリアライズしていた。安全側に倒した「合わなければ作り直す」設計は、失敗しても症状として現れないので、こういう見落としを隠す。修正は2行だが、見つけるのに人間1人とAI 3体のレビューが要った。
運用側のガード
コードで潰せるものは潰したうえで、当日それでも起きたときの判断をランブックに書いた。判断材料はすべてPlayer.logの特定の行にしてある。
| 確認すること | 基準 |
|---|---|
| プリウォームが本当に効いているか | イントロで「GPU vision warm-up 4/4」。ログにvision-prewarm-readyがあり、その後のsegmentation-initが300 ms未満 |
| プロセスがロックされていないか | stereo start refusedまたは戻り値-6が出たらアプリ再起動。F6(スタッフ用の、アプリを終了せずにBootから再初期化するキー)では戻らない |
| フォールバックビルドへ切り替える条件 | 同日にTDRか-6が2回目。パススルー無しの代替ビルドを用意してある |
| 展示前のソークテスト(長時間の連続稼働試験) | 20人分を通しで回し、TDRゼロ、-6ゼロ、全員がRVMフェーズに到達、姿勢推定の準備完了が19/20以上 |
| インストール先 | ASCIIのみのパス。ネイティブ側のエラー文字列がUTF-8のまま渡るため、日本語フォルダだと原因が読めなくなる |
特に最初の項目は、第4章の教訓そのものである。プリウォームが効いているかどうかは、画面上は何も変わらない。効いていなくても体験は始まるし、TDRが出るかどうかは確率の問題になる。だから「効いている証拠」を数値で決めて、当日の朝に見る。
あとがき
本編の第4章は「動かない推論を動かす」話だったが、この補遺は「動いている推論がGPUを道連れにしないようにする」話である。やったことを一行で言えば、重い処理を軽くしたのではなく、重い処理が起きる時刻と場所を選び直した、というだけになる。イントロ画面という誰も見ていない時間に全部済ませ、シーン中は引き取るだけにする。D3D11とCUDAが同じデバイスを触る瞬間は必ず同じロックを通す。planはそのPCで作る。消したはずのDLLは検証で弾く。
そして、その構造が本当に効いているかは、動いている画面を見ても分からなかった。「落ちなくなった」は「直った」の証拠にならない、というのがこの補遺の一番の教訓かもしれない。パスの区切り文字1つで空振りしていたプリウォームは、ログの1行を基準に決めておかなければ、展示当日まで空振りし続けていたはずである。